Ⅰ. Elasticsearch란?
- Elasticsearch는 Apache Lucene 기반의 Java 오픈소스 ‘분산 검색 엔진’이다.
- Elasticsearch를 통해 Lucene 라이브러리를 단독으로 사용할 수 있게 되며, 방대한 양의 데이터를 빠르게,
거의 실시간(NRT, Near-Real-Time이라고 표현)으로 저장, 검색, 분석할 수 있다.
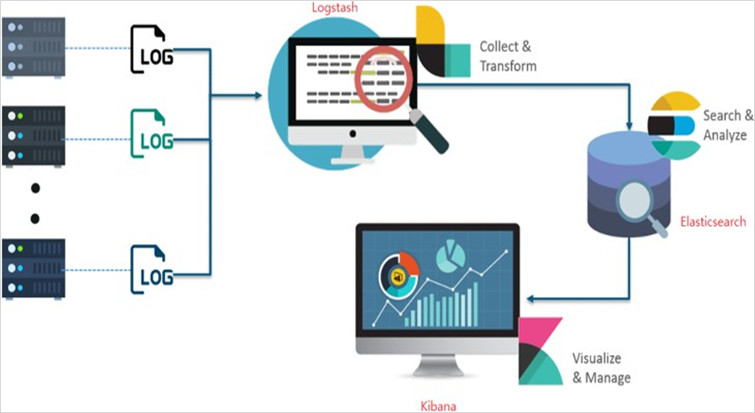
- Elasticsearch는 검색을 위해 단독으로 사용되기도 하며, Elastic Stack(ELK)으로 사용되기도 한다.
• Elastic Stack
- Logstash
; 다양한 소스(DB, csv 등)의 로그 또는 트랜잭션 데이터를 수집, 집계, 파싱하여 Elasticsearch로 전달
- Elasticsearch
; Logstash로부터 받은 데이터를 검색 및 집계하여, 필요한 정보를 획득
- Kibana
; Elasticsearch의 빠른 검색을 통한 데이터 시각화 및 모니터링 제공
Ⅱ. Elasticsearch와 RDBMS 비교
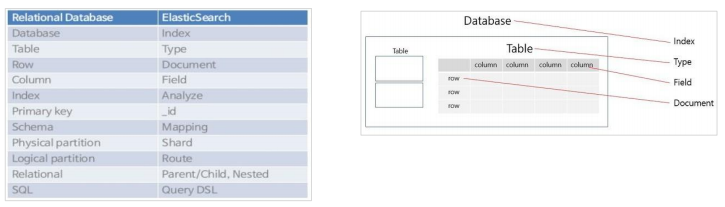
- ES는 7버전 이후 Type을 사용하지 않는다
; ES의 Type과 RDBMS의 Table을 대치해서 생각하면 안된다
; 7 이전 버전은 하나의 Index에 여러 Type을 사용하여 Index당 서로 다른 데이터를 관리할 수 있었지만, 7버전 이후
다른 역할의 데이터를 관리하기 위해선 Index를 추가해주어야 한다.
Ⅲ. Elasticsearch Architecture / 용어 정리
1) Cluster(클러스터)
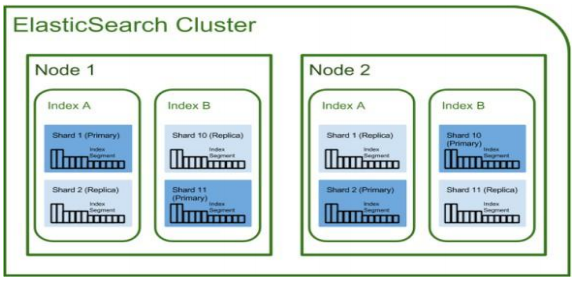
- 클러스터란 ES에서 가장 큰 시스템 단위를 의미하며, 최소 하나 이상의 노드로 이루어진 노드들의 집합이다.
- 서로 다른 클러스터는 데이터의 접근, 교환을 할 수 없는 독립적인 시스템으로 유지된다.
- 서버와 클러스터는 다음과 같이 구성될 수 있다.
; 여러 대의 서버가 하나의 클러스터를 구성할 수 있다.
; 한 서버에 여러 개의 클러스터가 존재할 수도 있다.
2) Node(노드)
- ES를 구성하는 하나의 단위 프로세스를 의미한다.
- 역할에 따라 각각의 노드로 구분할 수 있다.
• master-eligibl node (master node)
- 클러스터를 제어하는 마스터로 선택할 수 있는 노드
- master node의 역할
; 인덱스 생성, 삭제
; 클러스터 노드들의 추적, 관리
; 데이터 입력시 어느 샤드에 할당할 것인지 선택
• data node
- 데이터와 관련된 CRUD 작업과 관련 있는 노드
- CPU, 메모리 등 자원을 많이 소모하기 때문에 모니터링이 필요하다
- master node와 분리되는 것이 좋다
• ingest node
- 데이터를 변환하는 등 사전 처리 파이프라인을 실행하는 역할 수행
• coordination only node
- data node와 master node의 역할을 대신하는 node
- 대규모 클러스터에서 큰 이점을 갖는다
- 로드밸런서와 비슷한 역할을 수행한다
3) Index(인덱스) / Shard(샤드) / Replica(복제)
- Index
; ES의 Index는 RDBMS의 Database와 대응하는 개념이다.
; Shard와 Replica는 ES뿐만 아니라, 분산 데이터베이스 시스템에도 존재하는 개념이다.
- Shard
; 데이터를 분산해서 저장하는 방법을 의미한다
; Elasticsearch에서 Scale Out을 위해 Index를 쪼갠 것을 Shard라 한다.
; 기본적으로 1개가 존재하고, 검색 성능 향상을 위해 Cluster의 Shard 갯수를 튜닝하기도 한 다.
- Replica
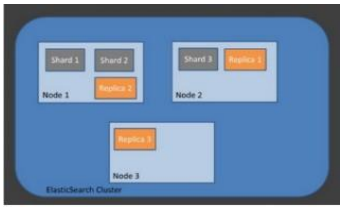
; 또 다른 형태의 Shard라 할 수 있다
; node가 손실했을 경우 데이터의 신뢰성을 위해 Shard들을 복사한 것
→ Replica는 서로 다른 node에 존재할 것을 권장한다.
Ⅳ. Elasticsearch 특징
- ES는 다음과 같은 특징이 있다
• Scale Out
- Shard를 통해 규모가 수평적으로 늘어날 수 있음
• 고가용성
- Replica를 통해 데이터의 안정성 보장
• Schema Free
- Json 문서를 통해 데이터 검색을 수행하므로 스키마 개념이 없음
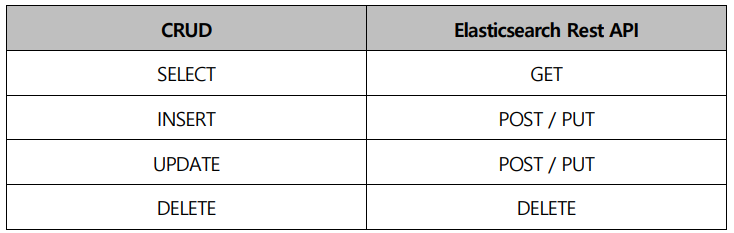
• Restful
- 데이터 CRUD 작업은 Http Method를 통해 수행하며, 각각 다음과 같이 대응된다.
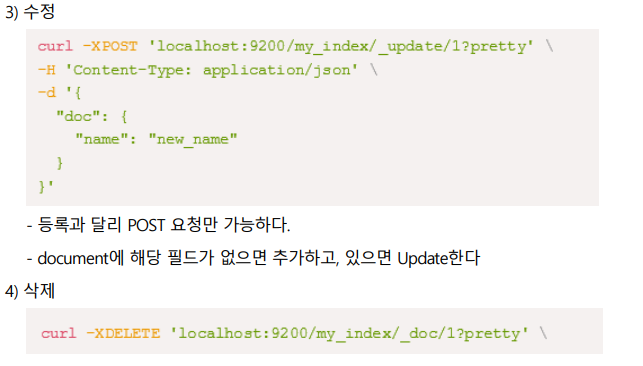
Ⅴ. 간단한 예제(document제어)
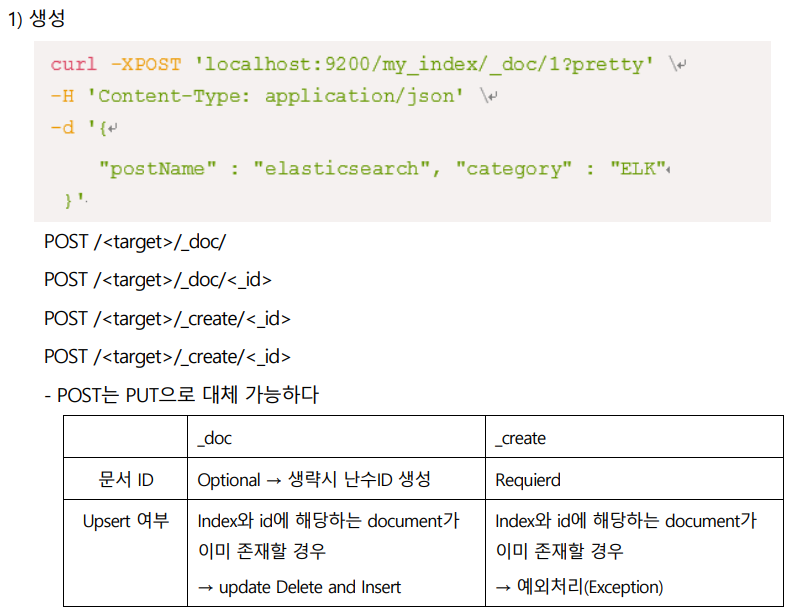
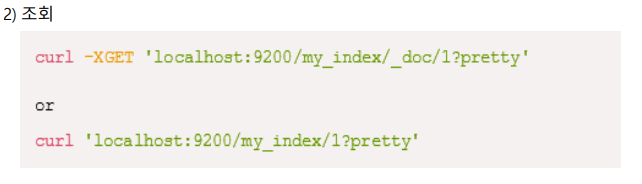
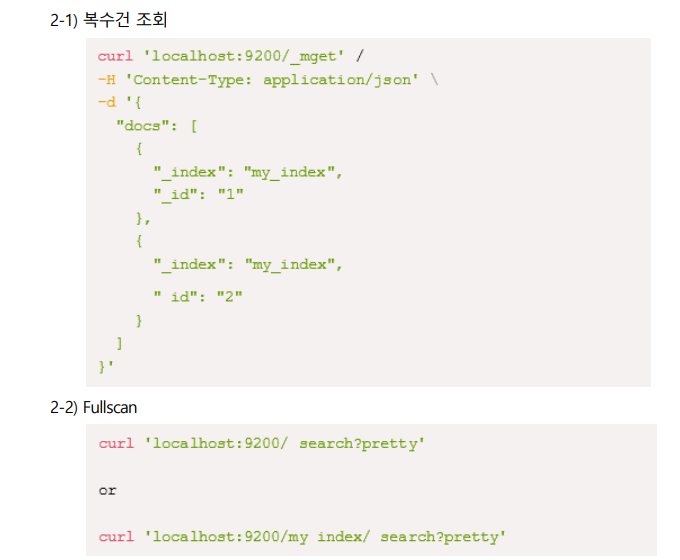
- Elasticsearch CRUD작업은 특징에서 살펴본 바와 같이 API를 호출해서 이루어진다.
- curl로 데이터를 넘겨줄 수도 있지만, json 파일을 저장해서 데이터를 넘길 수도 있고, json 포맷으로
queryDSL을 작성해서 API를 호출할 수도 있다.
Ⅵ. Inverted index (역색인)
- ES는 역색인을 사용하여, 빠른 검색이 가능하다.
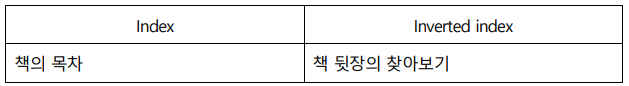
- ES는 텍스트를 파싱해서 검색어 사전을 만든 다음, inverted index 방식으로 저장한다.
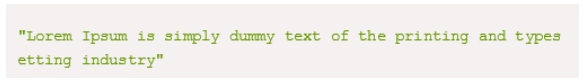
- 예를 들어, 이 문장을 모두 파싱해서 각 단어들(Lorem, Ipsum, is, simply……)을 저장하고, 대문자는 소문자 처리하고,
유사어도 체크하고 등의 작업을 통해 텍스트를 저장한다. 때문에 RDMS보다 전문검색(Full Test Search)에 빠른 성능을 보인다.
⭐발표자 : 이현승님


Ⅰ. Elasticsearch란?
- Elasticsearch는 Apache Lucene 기반의 Java 오픈소스 ‘분산 검색 엔진’이다.
- Elasticsearch를 통해 Lucene 라이브러리를 단독으로 사용할 수 있게 되며, 방대한 양의 데이터를 빠르게,
거의 실시간(NRT, Near-Real-Time이라고 표현)으로 저장, 검색, 분석할 수 있다.
- Elasticsearch는 검색을 위해 단독으로 사용되기도 하며, Elastic Stack(ELK)으로 사용되기도 한다.
• Elastic Stack
- Logstash
; 다양한 소스(DB, csv 등)의 로그 또는 트랜잭션 데이터를 수집, 집계, 파싱하여 Elasticsearch로 전달
- Elasticsearch
; Logstash로부터 받은 데이터를 검색 및 집계하여, 필요한 정보를 획득
- Kibana
; Elasticsearch의 빠른 검색을 통한 데이터 시각화 및 모니터링 제공
Ⅱ. Elasticsearch와 RDBMS 비교
- ES는 7버전 이후 Type을 사용하지 않는다
; ES의 Type과 RDBMS의 Table을 대치해서 생각하면 안된다
; 7 이전 버전은 하나의 Index에 여러 Type을 사용하여 Index당 서로 다른 데이터를 관리할 수 있었지만, 7버전 이후
다른 역할의 데이터를 관리하기 위해선 Index를 추가해주어야 한다.
Ⅲ. Elasticsearch Architecture / 용어 정리
1) Cluster(클러스터)
- 클러스터란 ES에서 가장 큰 시스템 단위를 의미하며, 최소 하나 이상의 노드로 이루어진 노드들의 집합이다.
- 서로 다른 클러스터는 데이터의 접근, 교환을 할 수 없는 독립적인 시스템으로 유지된다.
- 서버와 클러스터는 다음과 같이 구성될 수 있다.
; 여러 대의 서버가 하나의 클러스터를 구성할 수 있다.
; 한 서버에 여러 개의 클러스터가 존재할 수도 있다.
2) Node(노드)
- ES를 구성하는 하나의 단위 프로세스를 의미한다.
- 역할에 따라 각각의 노드로 구분할 수 있다.
• master-eligibl node (master node)
- 클러스터를 제어하는 마스터로 선택할 수 있는 노드
- master node의 역할
; 인덱스 생성, 삭제
; 클러스터 노드들의 추적, 관리
; 데이터 입력시 어느 샤드에 할당할 것인지 선택
• data node
- 데이터와 관련된 CRUD 작업과 관련 있는 노드
- CPU, 메모리 등 자원을 많이 소모하기 때문에 모니터링이 필요하다
- master node와 분리되는 것이 좋다
• ingest node
- 데이터를 변환하는 등 사전 처리 파이프라인을 실행하는 역할 수행
• coordination only node
- data node와 master node의 역할을 대신하는 node
- 대규모 클러스터에서 큰 이점을 갖는다
- 로드밸런서와 비슷한 역할을 수행한다
3) Index(인덱스) / Shard(샤드) / Replica(복제)
- Index
; ES의 Index는 RDBMS의 Database와 대응하는 개념이다.
; Shard와 Replica는 ES뿐만 아니라, 분산 데이터베이스 시스템에도 존재하는 개념이다.
- Shard
; 데이터를 분산해서 저장하는 방법을 의미한다
; Elasticsearch에서 Scale Out을 위해 Index를 쪼갠 것을 Shard라 한다.
; 기본적으로 1개가 존재하고, 검색 성능 향상을 위해 Cluster의 Shard 갯수를 튜닝하기도 한 다.
- Replica
; 또 다른 형태의 Shard라 할 수 있다
; node가 손실했을 경우 데이터의 신뢰성을 위해 Shard들을 복사한 것
→ Replica는 서로 다른 node에 존재할 것을 권장한다.
Ⅳ. Elasticsearch 특징
- ES는 다음과 같은 특징이 있다
• Scale Out
- Shard를 통해 규모가 수평적으로 늘어날 수 있음
• 고가용성
- Replica를 통해 데이터의 안정성 보장
• Schema Free
- Json 문서를 통해 데이터 검색을 수행하므로 스키마 개념이 없음
• Restful
- 데이터 CRUD 작업은 Http Method를 통해 수행하며, 각각 다음과 같이 대응된다.
Ⅴ. 간단한 예제(document제어)
- Elasticsearch CRUD작업은 특징에서 살펴본 바와 같이 API를 호출해서 이루어진다.
- curl로 데이터를 넘겨줄 수도 있지만, json 파일을 저장해서 데이터를 넘길 수도 있고, json 포맷으로
queryDSL을 작성해서 API를 호출할 수도 있다.
Ⅵ. Inverted index (역색인)
- ES는 역색인을 사용하여, 빠른 검색이 가능하다.
- ES는 텍스트를 파싱해서 검색어 사전을 만든 다음, inverted index 방식으로 저장한다.
- 예를 들어, 이 문장을 모두 파싱해서 각 단어들(Lorem, Ipsum, is, simply……)을 저장하고, 대문자는 소문자 처리하고,
유사어도 체크하고 등의 작업을 통해 텍스트를 저장한다. 때문에 RDMS보다 전문검색(Full Test Search)에 빠른 성능을 보인다.
⭐발표자 : 이현승님